Laurence-Olivier M. Foisy POL-2000 · séance 5 · jeu 1er oct
POL-2000 · Méthodologie quantitative
L’inférence statistique Séance 5 · jeudi 1er octobre 2026
Département de science politique Automne 2026 Où on en est POL-2000 · séance 5 · jeu 1er oct
lecture vous êtes ici 1 3 sept 2 10 sept 3 17 sept 4 24 sept 5 1 oct 6 8 oct 7 15 oct 8 22 oct 9 5 nov 10 12 nov 11 19 nov 12 26 nov 13 3 déc 14 10 déc 1 · Concepts de base 2 · Régression 3 · Inférence causale 05 jeudi 1er octobre · partie 1 · Concepts de base L'inférence statistique Ce que je vois dans un échantillon, puis-je le dire de toute la population ?
Examen 1 à remettre dimanche 4 octobre.
Retour POL-2000 · séance 5 · jeu 1er oct
Des questions sur la semaine dernière ? Aujourd’hui POL-2000 · séance 5 · jeu 1er oct
Aujourd’hui pause L’inférence Est-ce le hasard ? ggplot2 Un peu de R L’inférence POL-2000 · séance 5 · jeu 1er oct
L’inférence statistique Dire quelque chose du grand à partir du petit.
L’inférence POL-2000 · séance 5 · jeu 1er oct
Le défi de l’inférence mon échantillon 20 180 répondant.e.sCES 2025 Intérêt pour la politique : plus fort chez les 55+. 0 · pas du tout 10 · beaucoup 18-34 ans 6,0 55+ 7,3 la population Est-ce vrai pour tous les Canadien.ne.s ? 1 Mon échantillon ressemble-t-il à la population ? 2 Ce résultat pourrait-il venir du hasard ? Aujourd’hui : comment y répondre.
L’échantillon · 1936 POL-2000 · séance 5 · jeu 1er oct
1936 : le plus gros sondage de son temps 1936 · la Grande DépressionRoosevelt démocrate Landon républicain Le Literary Digest , 1924 Son sondage : toujours le bon gagnant 1916 1920 1924 1928 1932 10 millions de bulletins par la postelecteurs autos téléphones Votre pari : qui gagne ? Images : Wikimedia Commons · Roosevelt, FDR Presidential Library & Museum, CC BY 2.0 · Landon et couverture, domaine public
L’échantillon · 1936 POL-2000 · séance 5 · jeu 1er oct
La prévision, puis la réalité Le Digest prévoit : Landon gagne sur 2,3 millions de réponses Réalité : Roosevelt, et de loin 55 % prévu 37 % réel Landon −18 points 41 % prévu 61 % réel Roosevelt +20 points Une erreur d’environ 20 points. Avec 2,3 millions de réponses. L’échantillon · 1936 POL-2000 · séance 5 · jeu 1er oct
Quel était le problème ? l’électorat de 1936 ■ Roosevelt 61 % · ■ Landon 37 % · ■ autresschéma · les % sont les vrais ← moins aisés plus aisés → les listes du Digest 1 sur 4 a répondu le Digest a vu Landon 55 % la réalité Roosevelt 61 % 2,3 millions de réponses, mais pas les bonnes.
L’inférence POL-2000 · séance 5 · jeu 1er oct
Quatre mots schéma la population tout le monde qu’on veut décrire l’échantillon ceux qu’on observe ? le paramètre la vraie valeur, inconnue l’estimé ce qu’on calcule dans l’échantillon L’échantillon POL-2000 · séance 5 · jeu 1er oct
Au hasard schéma les plus faciles à joindre au hasard : tout le monde a la même chance d’être tirépas au hasard : un seul coin de la population
L’échantillon POL-2000 · séance 5 · jeu 1er oct
Et l’Étude électorale canadienne ? un panel en ligne (Léger) des quotas : région, genre, âge un échantillon 20 180 répondant.e.s la pondération corrige les écarts pas un échantillon aléatoire simple âge moyen des adultes Statistique Canada 48,6ans CES brute 49,7ans 1,1 an de plus CES pondérée 49,4ans 0,8 an de plus CES 2025, codebook, p. 9-10 · Statistique Canada, tableau 17-10-0005-01 L’échantillon POL-2000 · séance 5 · jeu 1er oct
La CES ressemble-t-elle au Canada ? Statistique Canada, 2025 CES brute CES pondérée 0 % 2 % 4 % 6 % 8 % 10 % 18 23 28 33 38 43 48 53 58 63 68 73 78 83 88 âge (tranches de cinq ans) Des quotas pour ressembler au Canada. Mais trop de 53 à 72 ans. Des quotas pour ressembler, des poids pour corriger le reste. Statistique Canada, tableau 17-10-0005-01 · Étude électorale canadienne 2025
L’échantillon POL-2000 · séance 5 · jeu 1er oct
Pondérer Un poids = % dans la population % dans l’échantillon 18 à 22 ans 7,4 5,2 = 1,4 CES 5,2 % Canada 7,4 % chacun compte pour 1,4 personne 58 à 62 ans 7,7 9,4 = 0,8 CES 9,4 % Canada 7,7 % chacun compte pour 0,8 personne Chaque répondant.e reçoit son poids. Trop peu nombreux : plus de 1. Trop nombreux : moins de 1.
L’échantillon POL-2000 · séance 5 · jeu 1er oct
Le poids, dans nos données > df_clean$ poids <- df_raw$ cps25_weight_general_allid age gauche_droite poids 1 69 8 0.58 2 61 3 0.63 3 54 7 0.57 4 28 7 0.79 5 63 NA 0.67 6 28 5 0.79 … … … …
df_clean : une ligne par répondant.e
la moyenne d’âge, brute puis pondérée
> df_clean |>
filter (! is.na (poids)) |>
summarise (brute = mean (age),
ponderee = weighted.mean (age, poids)) brute ponderee
1 49.7058 49.40888 les fonctions de R l’acceptent
lm (gauche_droite ~ age, data = df_clean,
weights = poids)ggplot (df_clean, aes (x = age, y = gauche_droite,
weight = poids))la régression : le 15 octobre
Notre budget POL-2000 · séance 5 · jeu 1er oct
Notre budget : 1 000 personnes notre population d’exercice Faisons comme si les 20 180 répondant.e.s de la CES étaient tout le Canada. 1 point = 20 répondant.e.s vote conservateur autre vote pas de vote déclaré la vraie réponse vote conservateur parmi les votes déclarés 33,1 % c’est le paramètre . Chaque sondage en donne un estimé . ici, on connaît la réponse budget : 1 000 personnes Comment choisir les 1 000 ? CES 2025, les 20 180 répondant.e.s, sans pondération Notre budget POL-2000 · séance 5 · jeu 1er oct
Facile, ou au hasard ? la population : 20 180 personnes le budget : 1 000 personnes la vraie réponse : 33,1 % nos voisins le Québec 20,5 % 12,6 points de trop peu si on était à Calgary l’Alberta 51,9 % 18,8 points de trop le campus les diplômé.e.s universitaires 22,7 % 10,4 points de trop peu les 65 ans et plus 25,8 % 7,3 points de trop peu 1 000 au hasard, parmi tout le monde 30,5 % à 2,6 points près 10 % 20 % 30 % 40 % 50 % 60 % vote conservateur
Notre budget POL-2000 · séance 5 · jeu 1er oct
Et si on recommençait ? 1 sondages au hasard moyenne : 33,1 % 1 sondages au Québec moyenne : 19,8 % autour de 19,8 % la vraie réponse : 33,1 % 15 20 25 30 35 40 45 part du vote conservateur dans chaque sondage (%) Plus de sondages ne corrigent pas une mauvaise méthode. Notre budget POL-2000 · séance 5 · jeu 1er oct
Et si le budget changeait ? chaque rangée : 1 000 sondages au hasard 100 personnes par sondage ± 11,5 points 1 000 personnes par sondage ± 3,5 points 4 000 personnes par sondage ± 1,6 points la vraie réponse : 33,1 % 10 15 20 25 30 35 40 45 50 55 part du vote conservateur dans chaque sondage (%) 4 fois plus de monde, 2 fois plus précis. C’est pourquoi les sondeurs s’arrêtent souvent autour de 1 000 personnes.
La courbe normale POL-2000 · séance 5 · jeu 1er oct
La planche de Galton simulation La cloche de nos 1 000 sondages, d’où vient-elle ? la courbe normale À chaque clou, la bille part à gauche ou à droite, au hasard. Pour finir au bord, il faut rebondir 12 fois du même côté : c’est rare. La plupart des billes finissent au milieu. La courbe normale POL-2000 · séance 5 · jeu 1er oct
Une personne, une classe NHANES · États-Unis, 2009 à 2012 six adultes, tirés au hasard 4 613 adultes 1 000 moyennes 4 pi 8 5 pi 5 pi 4 5 pi 8 6 pi 6 pi 4 taille (pieds et pouces) 4 pi 11 po 5 pi 4 po 5 pi 5 po 5 pi 7 po 5 pi 9 po 6 pi 5 pi 6 po plus petits plus grands Une personne : de 4 pi 11 po à 6 pi. Ça varie beaucoup. Les 4 613 adultes de l’enquête : de 4 pi 5 po à 6 pi 7 po. Les gens varient beaucoup. Une classe de 50 adultes, tirés au hasard. Sa taille moyenne : 5 pi 6 po. 1 000 classes de 50 : des moyennes de 5 pi 5 po à 5 pi 8 po. Les moyennes de classes varient très peu. Pourquoi ? Dans une classe, les grands et les petits s’annulent. une personne → un.e répondant.e varie beaucoup une classe de 50 → un sondage de 1 000 sa moyenne varie très peu
La courbe normale POL-2000 · séance 5 · jeu 1er oct
La courbe normale schéma une seule bosse, au milieu symétrique au centre : la moyenne aussi la médiane, et la valeur la plus fréquente la plupart, près du centre ← rares rares → La courbe normale · quiz POL-2000 · séance 5 · jeu 1er oct
Les données ou leurs moyennes ? La taille de 2 239 hommes adultes États-Unis, enquête NHANES, 2009 à 2012 ? les données une cloche 5 pi 5 pi 4 5 pi 8 6 pi 6 pi 4 6 pi 8 taille (pieds et pouces) et la moyenne de 50 hommes tirés au hasard ? 5 pi 8 5 pi 9 5 pi 10 1 000 moyennes, pieds et pouces Les données : déjà une cloche, et leurs moyennes aussi. La courbe normale · quiz POL-2000 · séance 5 · jeu 1er oct
Les données ou leurs moyennes ? Ce que les répondant.e.s pensent de Pierre Poilievre Étude électorale canadienne 2025, 20 180 répondant.e.s ? les données deux camps 0 20 40 60 80 100 note de 0 à 100 et la moyenne de 50 personnes tirées au hasard ? 30 40 50 1 000 moyennes, note sur 100 Les données : deux camps. Leurs moyennes : une cloche. La courbe normale · quiz POL-2000 · séance 5 · jeu 1er oct
Les données ou leurs moyennes ? La hauteur des 1 082 339 bâtiments de New York NYC Open Data, 2026 ? les données une longue queue la plus haute : 472 m 6 605 bâtiments de plus de 40 m 874 de plus de 100 m 94 de plus de 200 m 0 100 200 300 400 hauteur (m) et la moyenne de 2 000 bâtiments tirés au hasard ? 8,2 8,4 8,6 8,8 1 000 moyennes (m) Les données : une longue queue. Leurs moyennes : une cloche. La courbe normale · quiz POL-2000 · séance 5 · jeu 1er oct
Les données ou leurs moyennes ? L’âge des 20 180 répondant.e.s de l’Étude électorale Étude électorale canadienne 2025 ? les données un plateau 20 40 60 80 100 âge (ans) et la moyenne de 50 personnes tirées au hasard ? 40 45 50 55 1 000 moyennes (ans) Les données : un plateau. Leurs moyennes : une cloche. Le hasard POL-2000 · séance 5 · jeu 1er oct
Le théorème central limite les bâtiments de New York longue queue moyennes de 2 000 une cloche l’âge des répondant.e.s plateau moyennes de 50 une cloche la note de Poilievre deux camps moyennes de 50 une cloche Peu importe la forme des données, si on tire des échantillons au hasard, leurs moyennes forment une cloche. Et un pourcentage, c’est aussi une moyenne : 1 pour conservateur, 0 sinon. Deux conditions : un vrai hasard, et des échantillons assez grands. L’écart type POL-2000 · séance 5 · jeu 1er oct
L’écart type Étude électorale canadienne 2025 · âge dans R : sd() âge 20 30 40 50 60 70 80 90 100 moyenne · 49,7 ans 19 ans 69 ans 11 ans 61 ans 4 ans 54 ans 22 ans 28 ans 13 ans 63 ans 22 ans 28 ans écart type · 17,5 ans 17,5 ans 17,5 ans six des 20 180 répondant.e.s, avec leur âge chaque personne est à une certaine distance de la moyenne À quelle distance se trouve une personne typique ? L’écart type : la distance typique à la moyenne. calculé par R sur les 20 180 répondant.e.s 6 personnes sur 10 ont entre 33 et 67 ans. à moins d’un écart type de la moyenne, sur les 20 180 Petit écart type : tout le monde se ressemble. Grand écart type : ça varie beaucoup. La marge d’erreur POL-2000 · séance 5 · jeu 1er oct
La marge d’erreur Est-ce la vraie réponse ? Probablement pas exactement. Le même sondage qu’à « Facile, ou au hasard ? » 1 000 sondages de 1 000, 1 000 parts conservatrices 26 % 28 % 30 % 32 % 34 % 36 % 38 % 40 % ± 3,5 points 952 sur 1 000 à moins de 3,5 points de la vraie réponse à peu près 19 sur 20 la vraie réponse : 33,1 % notre sondage au hasard : 30,5 % 2,6 points ± 3,5 points autour de notre sondage 27,0 34,0 La règle, posée sur notre sondage : la vraie réponse est dedans. 19 fois sur 20, ça marche. C’est la marge d’erreur. 30,5 % notre sondage 682 déclarent un vote 3 sur 10 votent conservateur : les gens sont très partagés 46 l’écart type des gens 0 50 tout le monde pareil moitié-moitié ÷ √682 ≈ 26 les hasards s’annulent en partie 1,8 point l’écart type des sondages × environ 2 ± 3,5 points la marge d’erreur Un seul sondage suffit pour trouver sa marge. Le même 1,8 que nos 1 000 sondages simulés (1,8). La marge d’erreur POL-2000 · séance 5 · jeu 1er oct
Le calcul, pas à pas 1 Notre sondage 30,5 % 682 votes déclarés, 3 sur 10 conservateurs 2 Combien les gens varient 46 l’écart type des gens : très partagés (0 = tout le monde pareil, 50 = moitié-moitié) 3 Combien les sondages varient 46 ÷ √682 ≈ 1,8 point l’erreur type (√682 ≈ 26) : les hasards s’annulent en partie 4 La marge d’erreur 2 × 1,8 ≈ ± 3,5 points fois environ 2 : 19 sondages sur 20 tombent dans cet écart 5 La fourchette de 27,0 à 34,0 % la vraie réponse, 33,1 %, est dedans ✓
La marge d’erreur POL-2000 · séance 5 · jeu 1er oct
19 fois sur 20 dans le journal Conservateurs : 30,5 % marge d’erreur de ± 3,5 points , 19 fois sur 20 la vraie réponse : 33,1 % notre sondage au hasard, 1 000 personnes 27,0 34,0 la règle de la marge d’erreur, posée sur 30,5 % ici, on la connaît. Le sondeur, non. 20 sondages de 1 000 le nôtre, celui du journal celui-ci rate, par hasard 25 % 30 % 35 % 40 % C’est la méthode qui a raison 19 fois sur 20.
Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
Le test d’hypothèse nulle Mon résultat, est-ce le hasard ?
Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
La pomicultrice des centaines de milliers de pommes Exemple fictif · Arel-Bundock (2021, p. 62) Le panier, c’est l’échantillon . Le lot, c’est la population . un échantillon aléatoire de 50 pommes l’acheteur exige un poids moyen de plus de 100 g moyenne : 105 g 105 g : assez pour conclure que la vraie moyenne dépasse 100 g ? Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
La conversation L’acheteur n’accepte que les lots de plus de 100 g en moyenne. la pomicultrice l’acheteur H1 · ce qu’elle affirme H0 · l’hypothèse nulle Mon panier de 50 pommes pèse 105 g en moyenne. Mon lot dépasse 100 g. Peut-être que ton lot est juste à 100 g, ou moins, et que tu es tombée sur un bon panier, par chance. D’accord, supposons que tu as raison. À quel point mon panier serait-il chanceux ? Exemple fictif · d’après Arel-Bundock (2021, p. 62-63) Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
Présumée vraie schéma en statistique
l’accusée est présumée innocente
H0 est présumée vraie
les preuves
les données
soit assez de preuves : coupable
soit des données très surprenantes : on rejette H0
soit pas assez de preuves : acquittée, mais pas déclarée « innocente »
soit pas assez surprenantes : on ne rejette pas H0. On ne dit jamais « H0 est vraie ». Arel-Bundock (2021, p. 75)
Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
Le monde de l’acheteur À quoi ressemblent les paniers d’un lot à 100 g ? 1 la forme : une cloche (le théorème central limite) 2 le centre : 100 g (ce que dit l’acheteur) 3 la largeur : les paniers varient de 2,5 g (pas 17 g comme une pomme) en pointillé : si les pommes variaient beaucoup plus (schéma) 90 g 95 g 100 g 105 g 110 g poids moyen d’un panier de 50 son panier : 105 g Dans le monde de l’acheteur, 105 g, c’est au bout de la cloche. Combien de paniers pèsent autant ? On va compter. Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
Compter les paniers simulation · pommes fictives Imaginons que l’acheteur a raison. Un lot juste à 100 g. 90 g 95 g 100 g 105 g 110 g poids moyen du panier 100,7 g 97,3 g son panier : 105 g 27 sur 1 000 pèsent 105 g ou plus Si tu avais raison, un panier comme le mien arriverait environ 3 fois sur 100. la pomicultrice C’est rare. Je ne crois plus à la chance. l’acheteur On rejette H0. Si c’était le hasard, ça arriverait moins de 5 fois sur 100. 5 sur 100, c’est le 1 sur 20 de la marge d’erreur. Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
Pourquoi le monde à 100 g ? schéma · comptes simulés, pommes fictives H0 100 g ou moins Et si ton lot pesait 99 g ? 98 g ? l’acheteur son panier : 105 g paniers de 105 g ou plus 100 g 27 sur 1 00099 g 6 sur 1 00098 g 0 sur 1 000le plus favorable à H0 … 90 g 95 g 100 g 105 g 110 g À 100 g, c’est déjà rare. Plus léger, c’est encore plus rare. la pomicultrice On ne peut pas prouver H1 directement. On montre que H0 explique très mal son panier. Ça donne du poids à H1. Est-ce le hasard ? POL-2000 · séance 5 · jeu 1er oct
Et si son panier avait pesé 102 g ? simulation · pommes fictives Le même lot, juste à 100 g. 1 000 paniers, une cloche autour de 100 g 90 g 95 g 100 g 105 g 110 g poids moyen du panier 100,7 g 97,3 g un panier : 102 g 217 sur 1 000 pèsent 102 g ou plus 22 fois sur 100 ? Ça peut être la chance. Pas convaincu. l’acheteur On ne rejette pas H0 : on ne peut pas conclure. 22 fois sur 100, c’est bien plus que 5. Pause POL-2000 · séance 5 · jeu 1er oct
ggplot2 POL-2000 · séance 5 · jeu 1er oct
ggplot2 Un graphique se construit en couches.
ggplot2 POL-2000 · séance 5 · jeu 1er oct
La grammaire des graphiques schéma note_carney note_poilievre vote x = note_carneyy = note_poilievreles données les esthétiques aes() les géométries geom_...() les données + les esthétiques + les géométries Wickham (2010), A Layered Grammar of Graphics
ggplot2 POL-2000 · séance 5 · jeu 1er oct
Le gabarit ggplot (data = <DONNÉES> aes (<CORRESPONDANCES> )+
<GEOM> ()LE GABARIT trois blancs à remplir
LES DONNÉES quel tableau ?
LES CORRESPONDANCES quelle variable va où : x, y, couleur
LA GÉOMÉTRIE quelle forme : points, barres, lignes
LE + ajoute une couche
REMPLI ggplot (ces1000 , aes (x = note_carney, y = note_poilievre)+
geom_point ()Wickham, Çetinkaya-Rundel et Grolemund (2023), R for Data Science , 2e éd., chap. 1 En direct · ggplot2 POL-2000 · séance 5 · jeu 1er oct
Les données : la CES 2025 > ces <- df_raw |>
transmute (note_carney = as.numeric (cps25_lead_rating_23),
note_poilievre = as.numeric (cps25_lead_rating_24),
vote = factor (as.numeric (cps25_votechoice), levels = 1 : 5 ,
labels = c ("Libéral" , "Conservateur" , "NPD" ,
"Bloc" , "Vert" ))) |>
filter (note_carney > = 0 , note_poilievre > = 0 , ! is.na (vote))-99 veut dire « pas de réponse » : on l’écarte, comme les personnes sans vote déclaré. as.numeric() retire la question anglaise collée à la colonne.
> ▍ En direct · ggplot2 POL-2000 · séance 5 · jeu 1er oct
1 000 répondant.e.s, au hasard > set.seed (2025 )
ces1000 <- slice_sample (ces, n = 1000 )Notre budget : 1 000 répondant.e.s, tiré.e.s au hasard.
> head (ces1000)# A tibble: 6 × 3
note_carney note_poilievre vote
<dbl> <dbl> <fct>
1 84 0 Libéral
2 81 0 Libéral
3 36 21 Libéral
4 84 1 Libéral
5 10 10 Bloc
6 67 35 Libéral Deux notes de 0 à 100, et le vote.
> ▍ ggplot2 · couche par couche POL-2000 · séance 5 · jeu 1er oct
Les données, puis les axes ggplot (ces1000, aes (x = note_carney, y = note_poilievre))
ggplot2 · couche par couche POL-2000 · séance 5 · jeu 1er oct
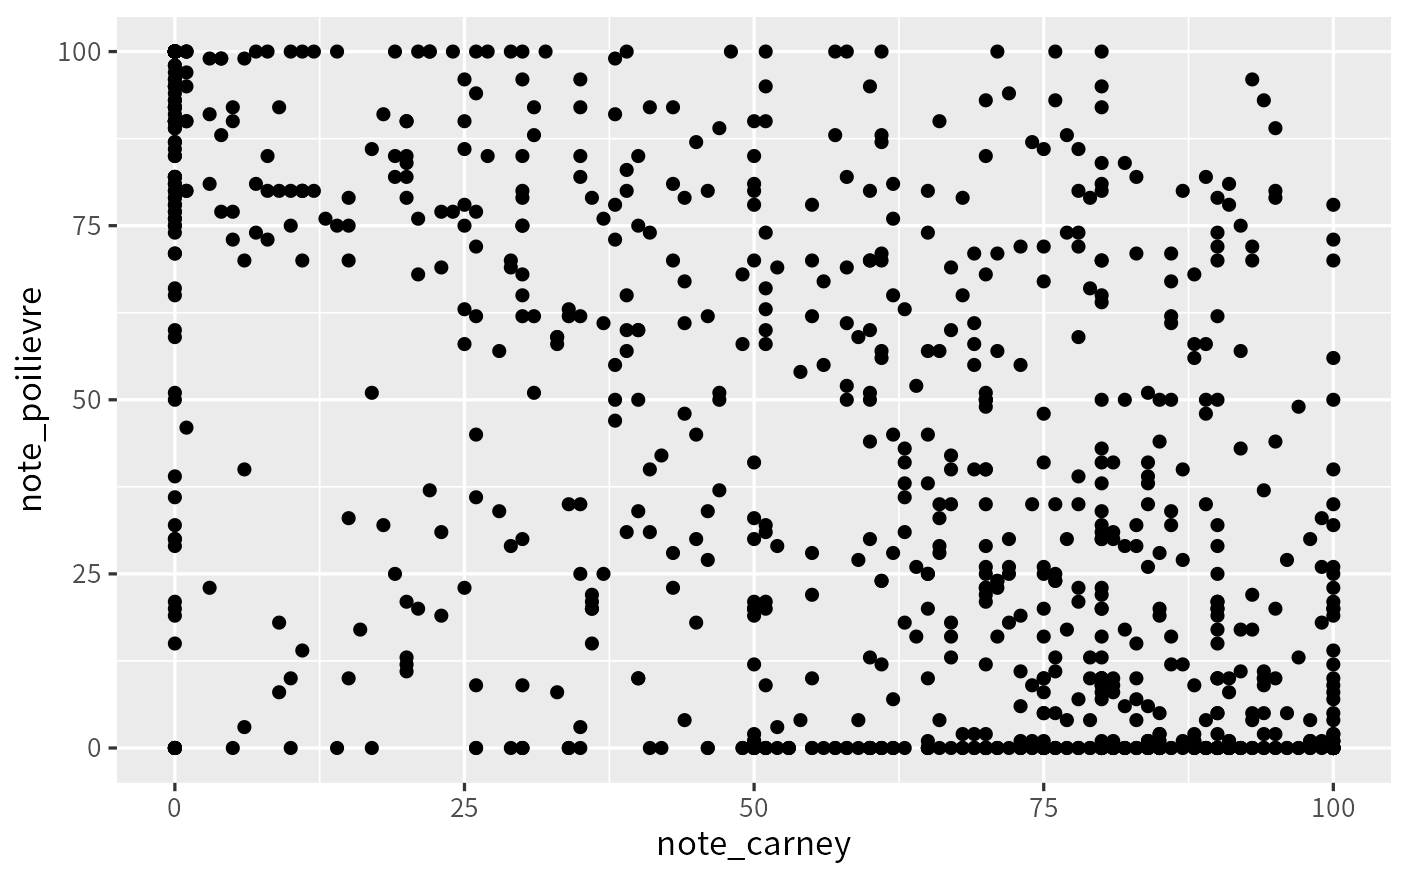
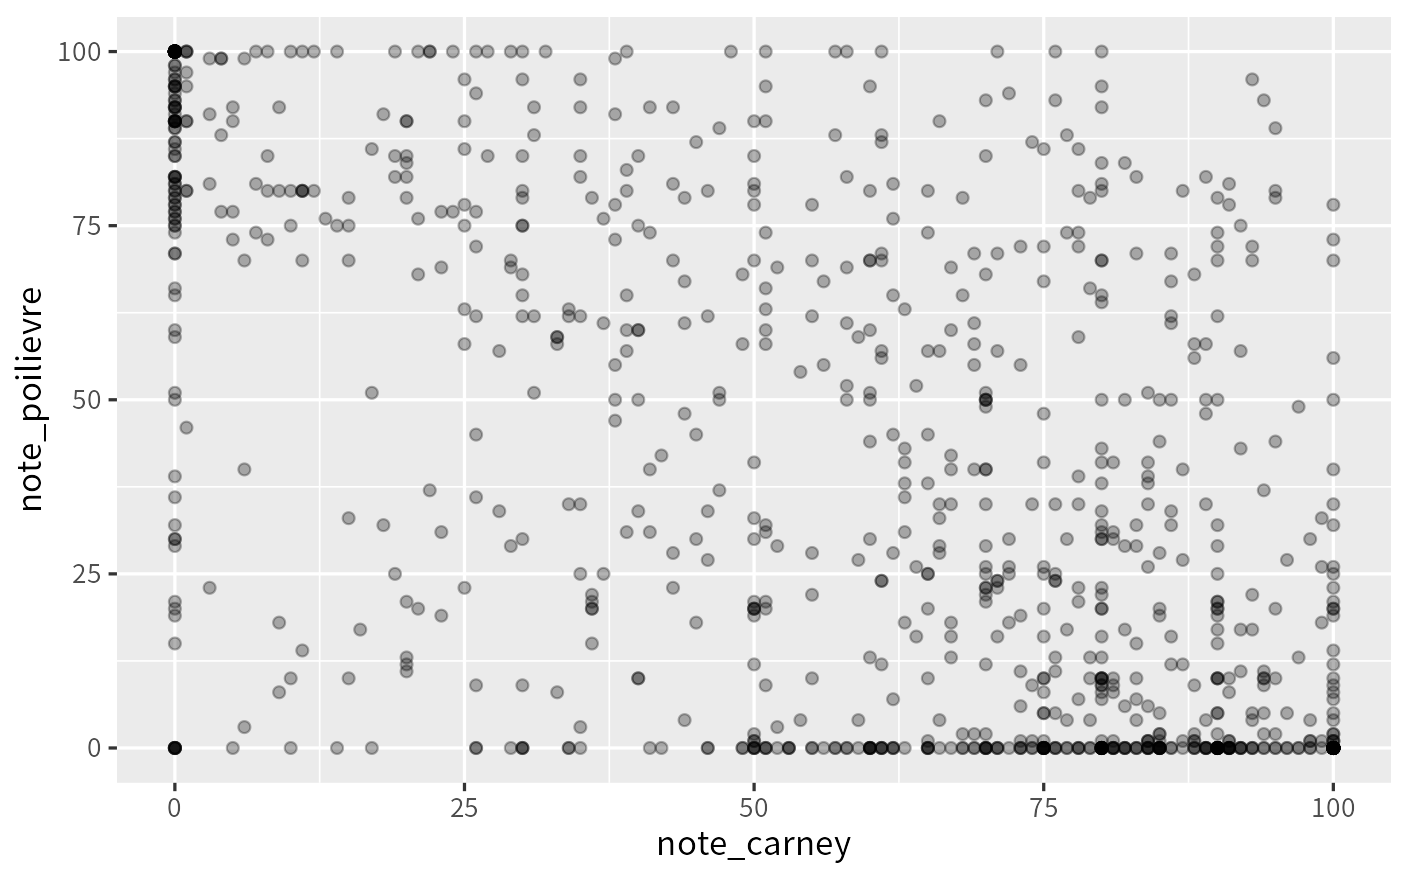
Les points, puis la transparence ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point ()
ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (alpha = 0.3 )
ggplot2 · couche par couche POL-2000 · séance 5 · jeu 1er oct
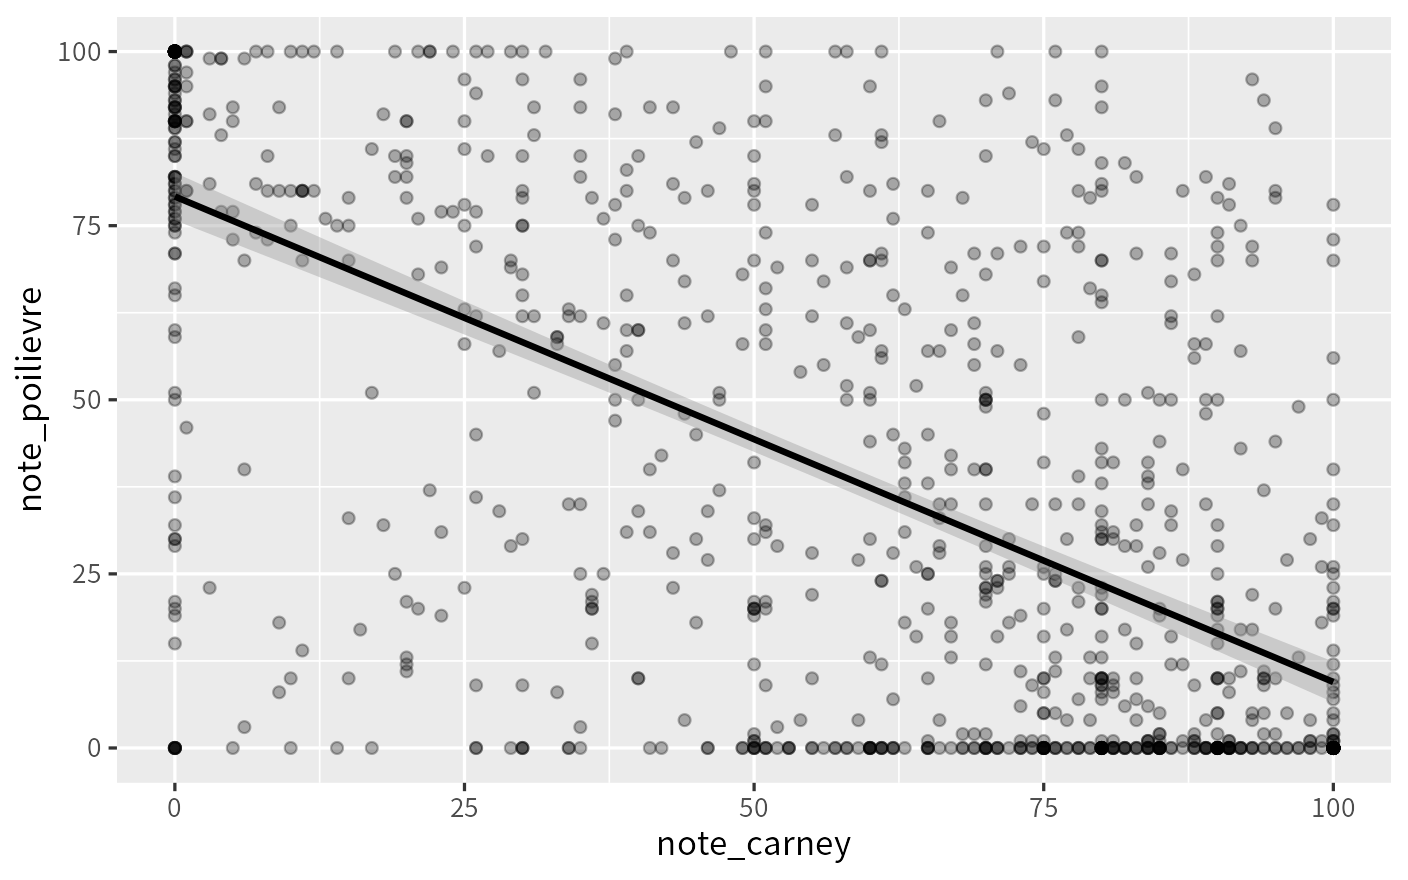
Une tendance ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (alpha = 0.3 ) +
geom_smooth (method = "lm" , colour = "black" )
R dit : `geom_smooth()` using formula = 'y ~ x'
ggplot2 · couche par couche POL-2000 · séance 5 · jeu 1er oct
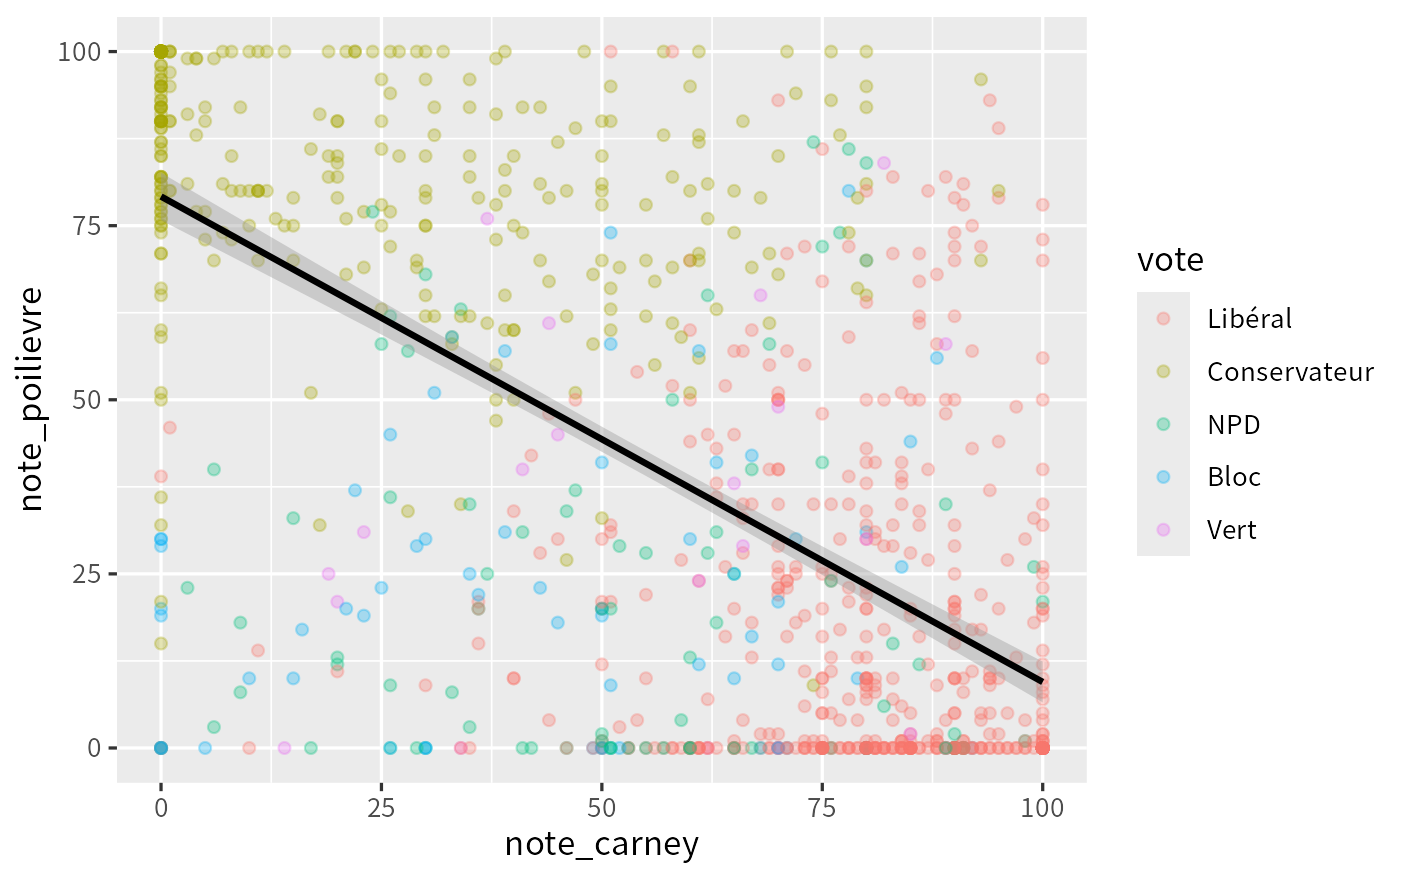
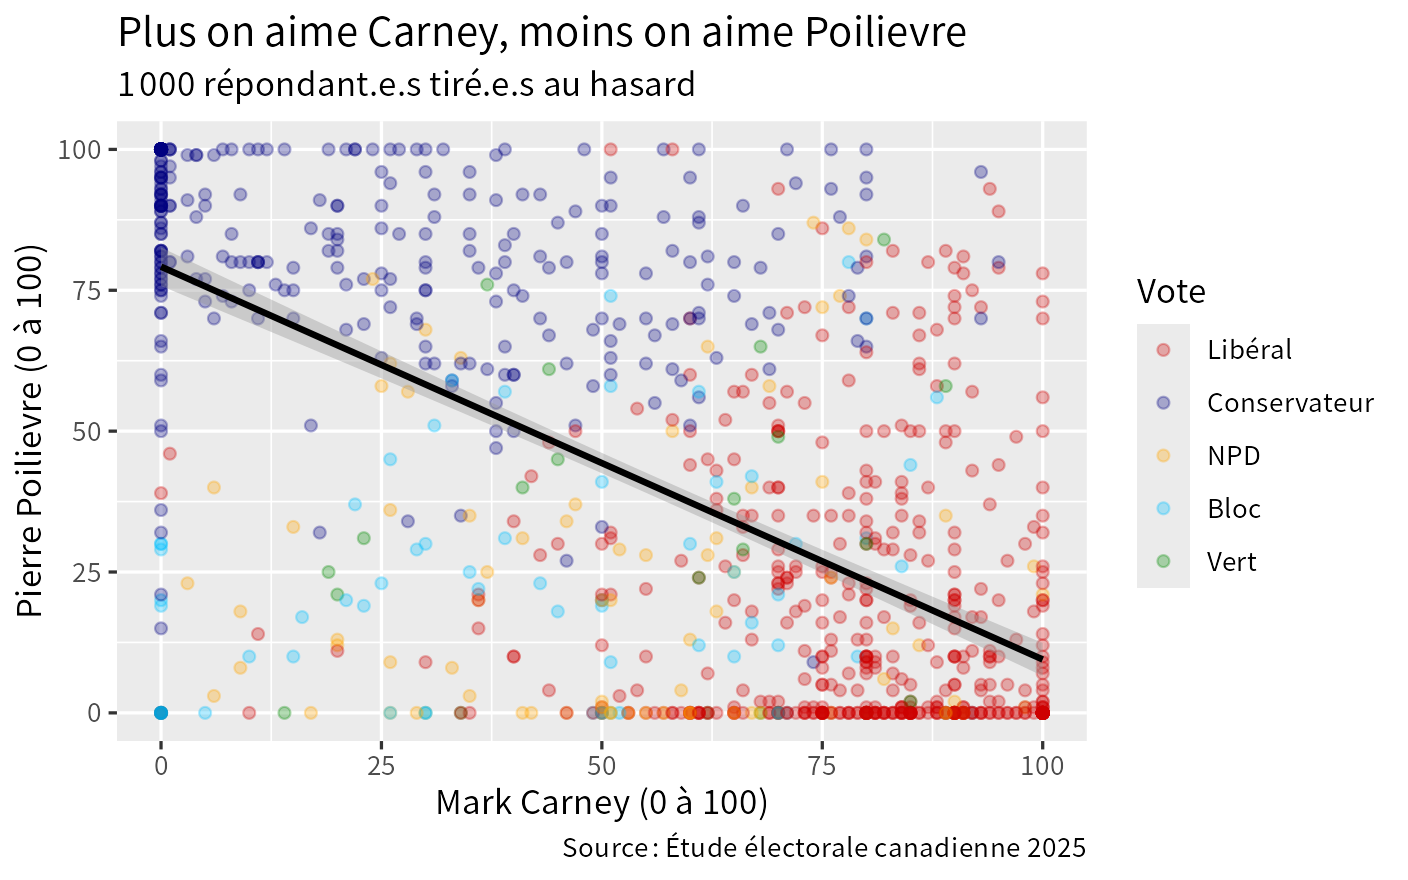
Une troisième variable, puis nos couleurs ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (aes (colour = vote), alpha = 0.3 ) +
geom_smooth (method = "lm" , colour = "black" )
R dit : `geom_smooth()` using formula = 'y ~ x'
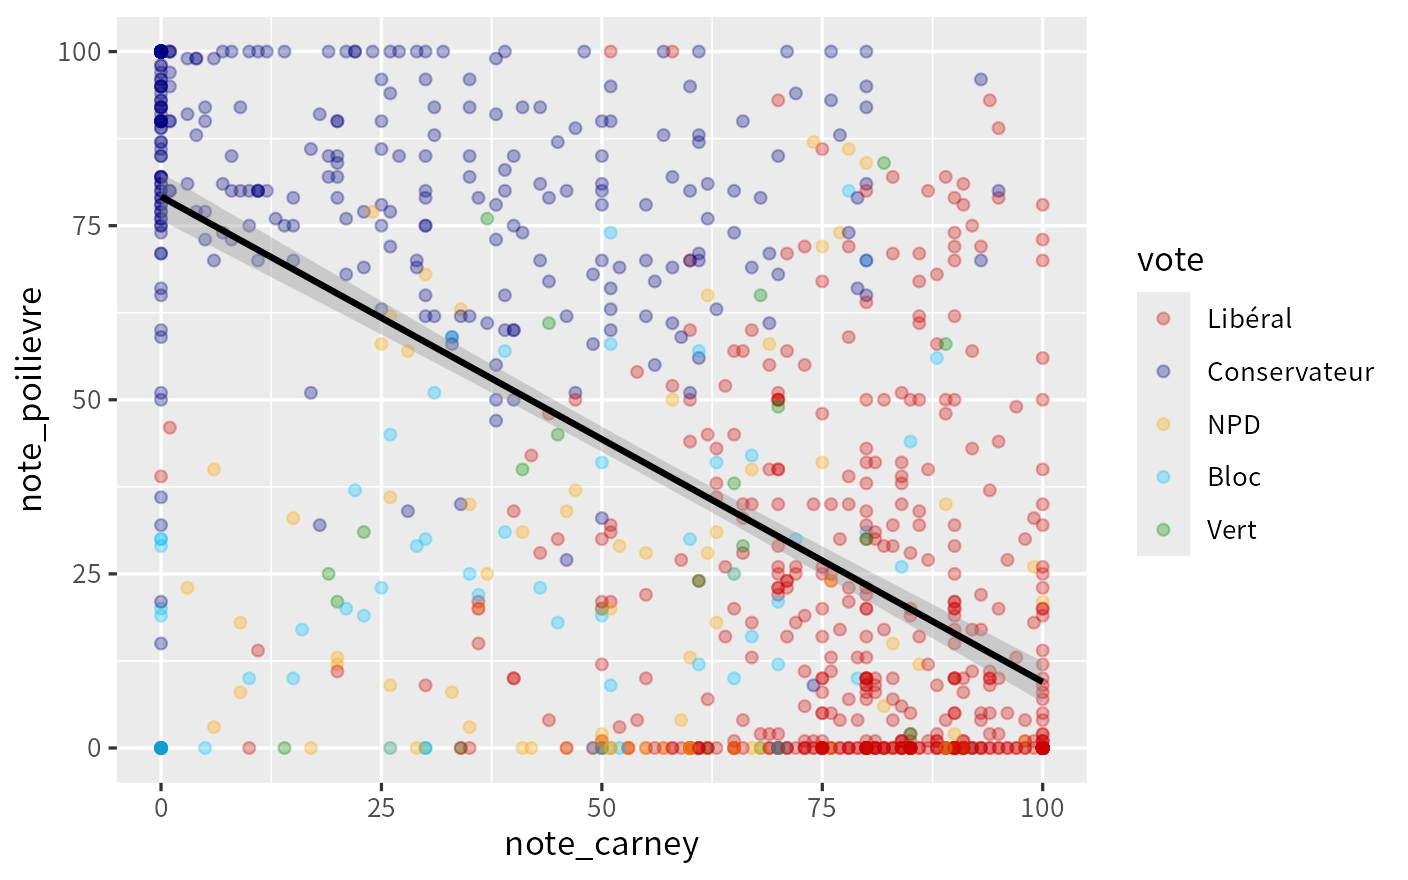
ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (aes (colour = vote), alpha = 0.3 ) +
geom_smooth (method = "lm" , colour = "black" ) +
scale_colour_manual (values = c ("red3" , "navy" , "orange" ,
"deepskyblue" , "green4" ))
R dit : `geom_smooth()` using formula = 'y ~ x'
ggplot2 · couche par couche POL-2000 · séance 5 · jeu 1er oct
L’habillage ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (aes (colour = vote), alpha = 0.3 ) +
geom_smooth (method = "lm" , colour = "black" ) +
scale_colour_manual (values = c ("red3" , "navy" , "orange" ,
"deepskyblue" , "green4" )) +
labs (title = "Plus on aime Carney, moins on aime Poilievre" ,
subtitle = "1 000 répondant.e.s tiré.e.s au hasard" ,
x = "Mark Carney (0 à 100)" ,
y = "Pierre Poilievre (0 à 100)" ,
colour = "Vote" ,
caption = "Source : Étude électorale canadienne 2025" )
R dit : `geom_smooth()` using formula = 'y ~ x'
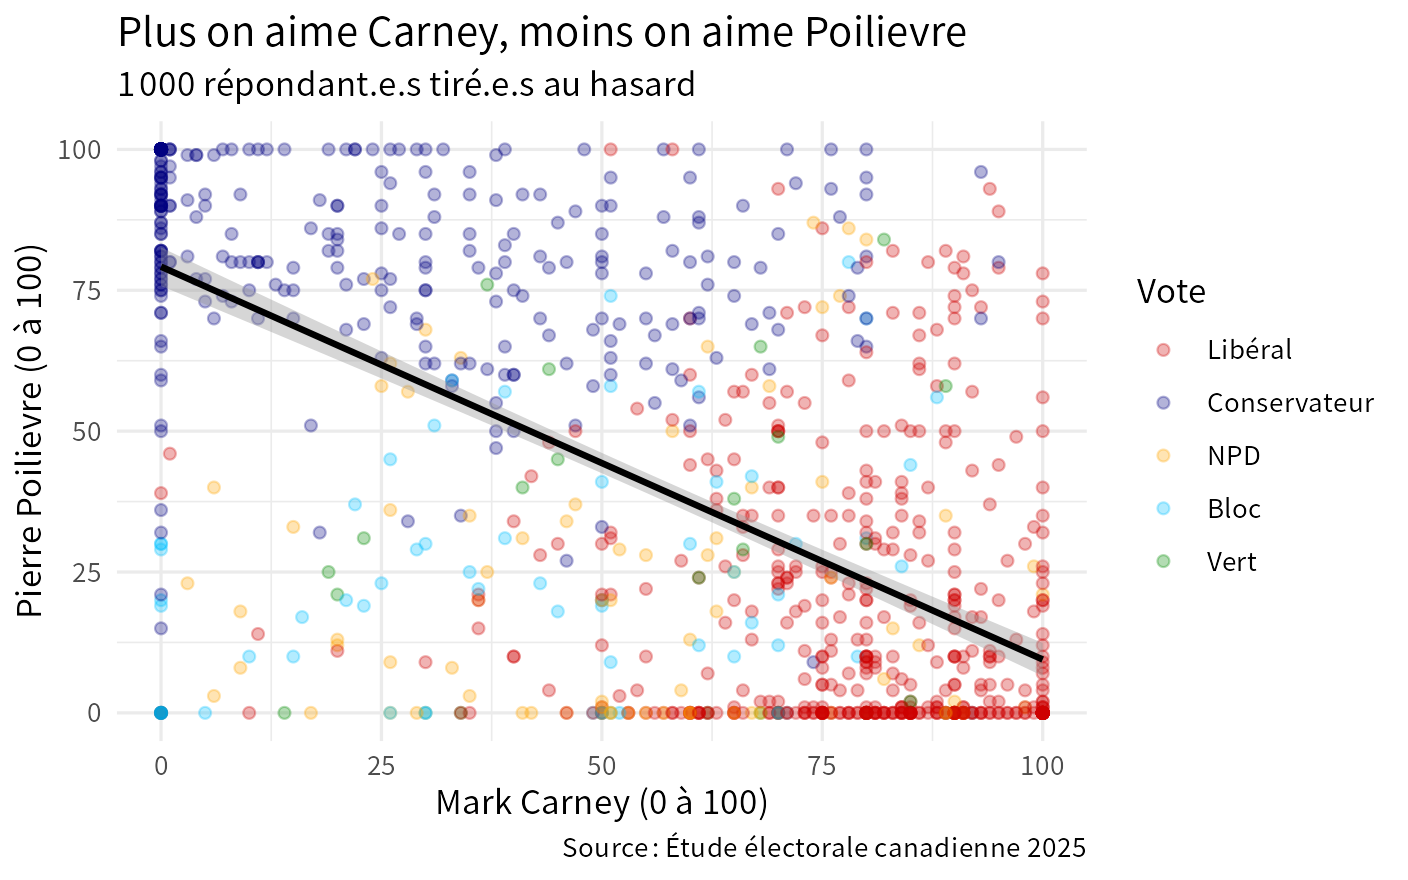
ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (aes (colour = vote), alpha = 0.3 ) +
geom_smooth (method = "lm" , colour = "black" ) +
scale_colour_manual (values = c ("red3" , "navy" , "orange" ,
"deepskyblue" , "green4" )) +
labs (title = "Plus on aime Carney, moins on aime Poilievre" ,
subtitle = "1 000 répondant.e.s tiré.e.s au hasard" ,
x = "Mark Carney (0 à 100)" ,
y = "Pierre Poilievre (0 à 100)" ,
colour = "Vote" ,
caption = "Source : Étude électorale canadienne 2025" ) +
theme_minimal ()
R dit : `geom_smooth()` using formula = 'y ~ x'
ggplot2 POL-2000 · séance 5 · jeu 1er oct
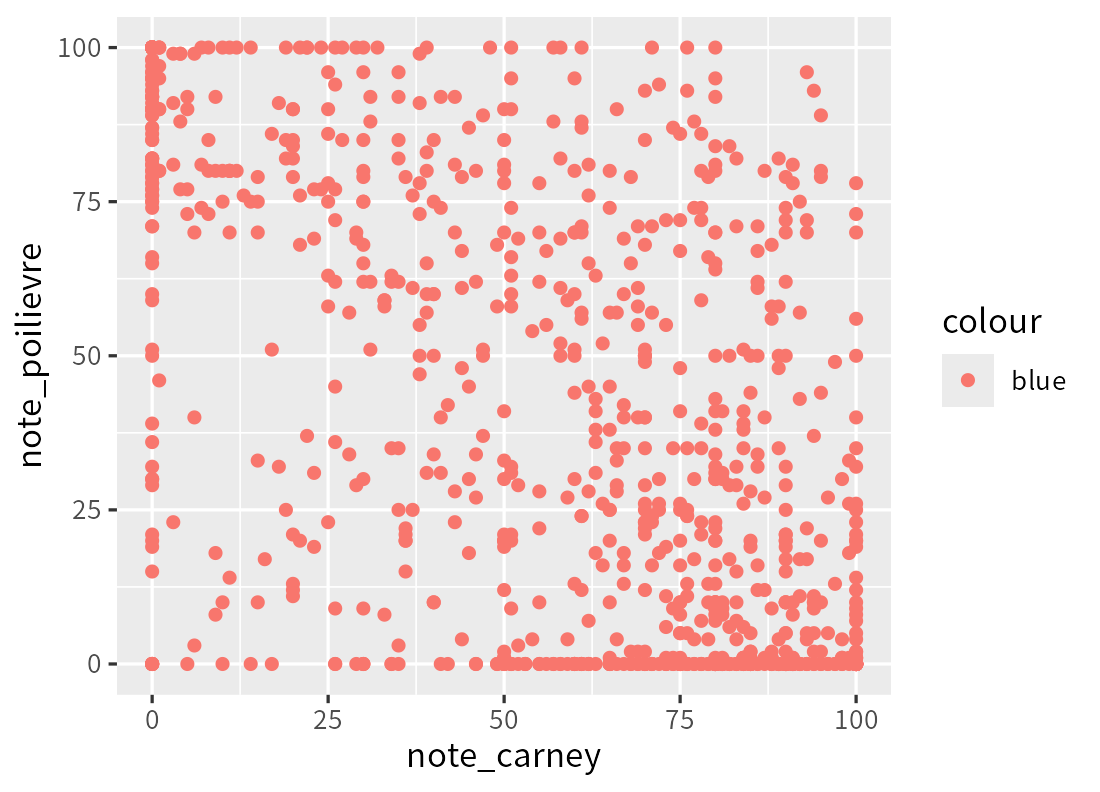
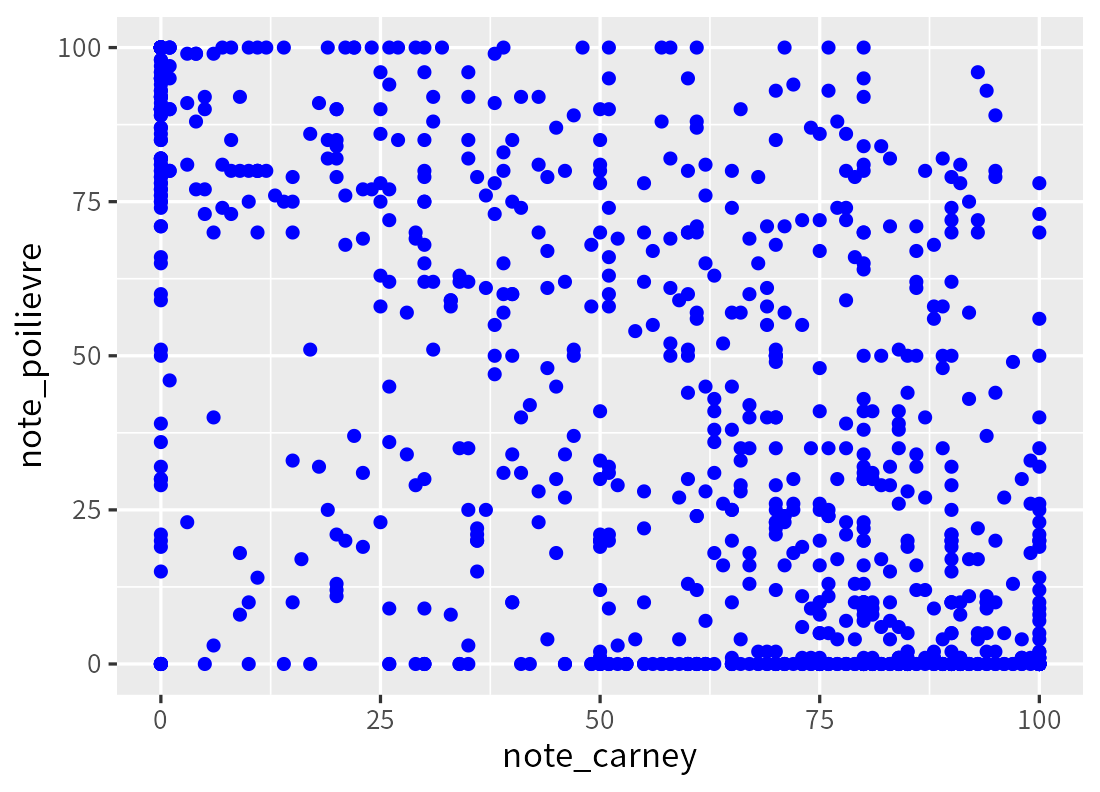
Dans aes(), ou hors de aes() ? dans aes() : R y voit une variable
ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (aes (colour = "blue" ))hors de aes() : une couleur fixe
ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point (colour = "blue" )aes() relie une variable à une propriété du dessin.
ggplot2 POL-2000 · séance 5 · jeu 1er oct
Deux erreurs classiques ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) |>
geom_point ()Error in `geom_point()`:
! `mapping` must be created by `aes()`.
✖ You've supplied a <ggplot2::ggplot> object.
ℹ Did you use `%>%` or `|>` instead of `+`? le + relie les couches de ggplot2, pas |>
ggplot (ces1000, aes (x = note_carney, y = note_poilievre))
+ geom_point ()Error in `+.gg`:
! Cannot use `+` with a single argument.
ℹ Did you accidentally put `+` on a new line? le + va à la fin de la ligne, jamais au début
ggplot2 · rappel POL-2000 · séance 5 · jeu 1er oct
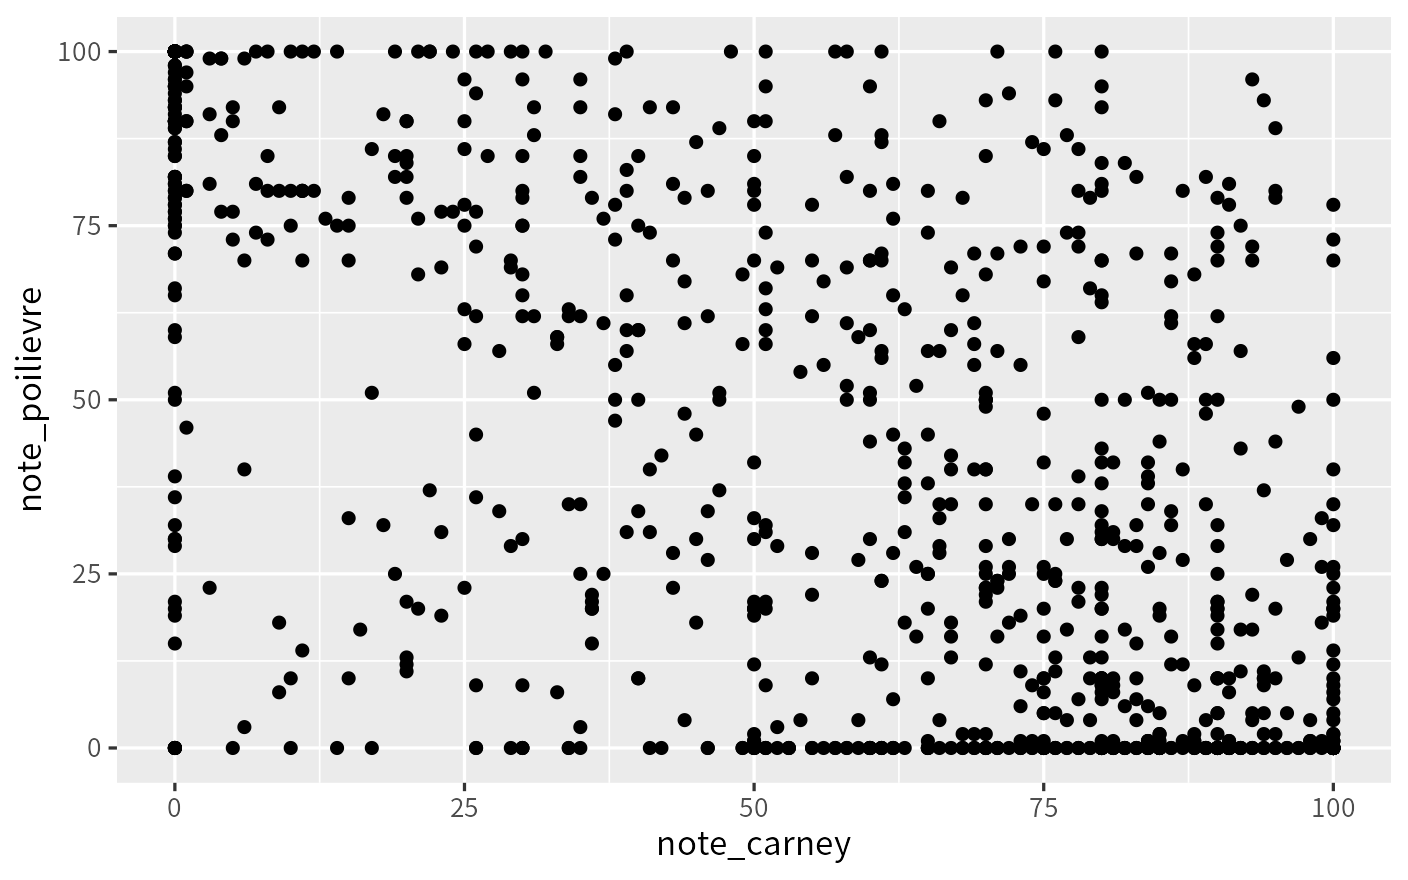
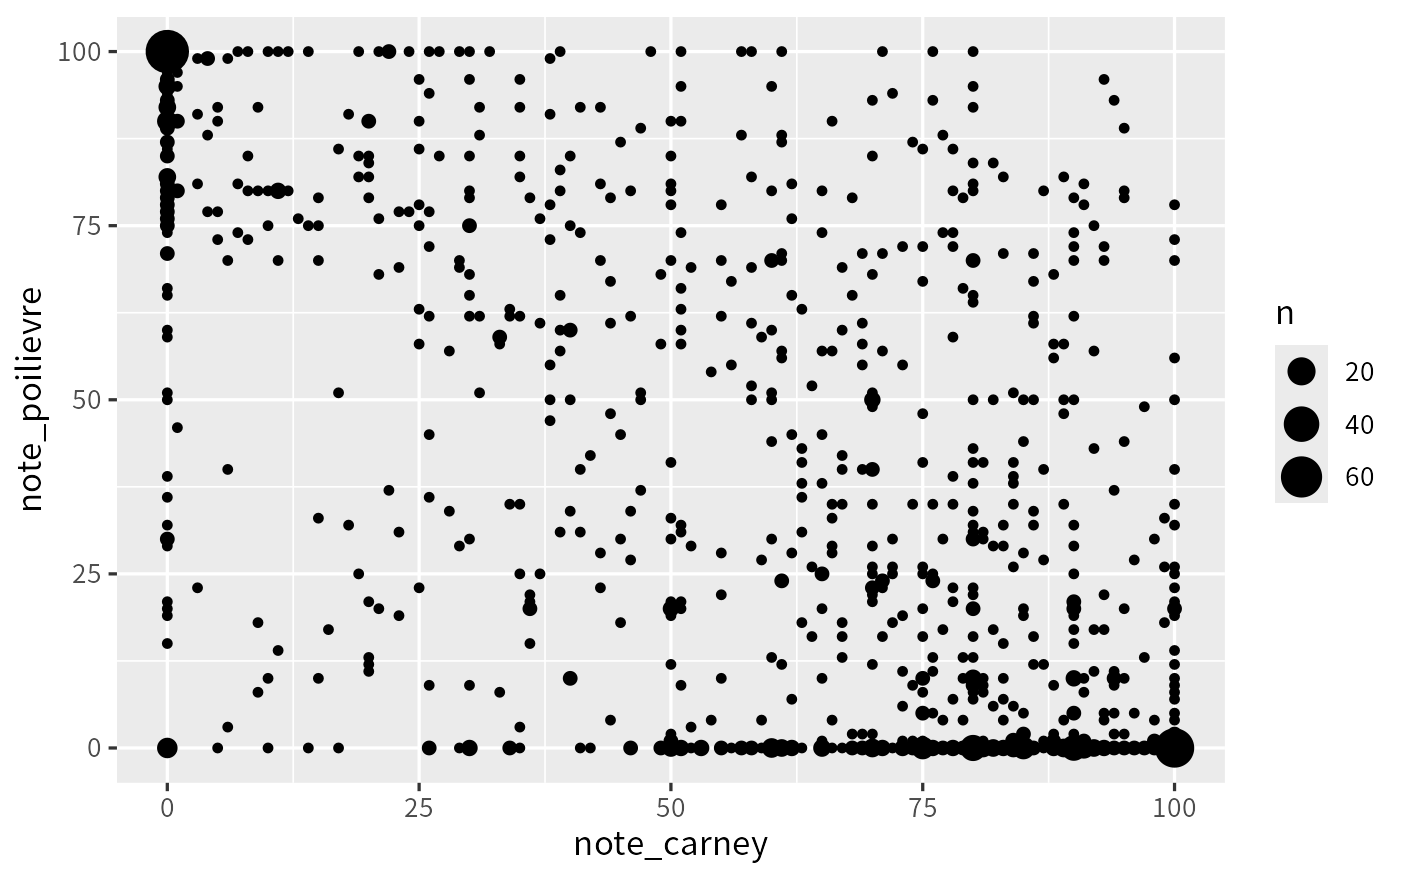
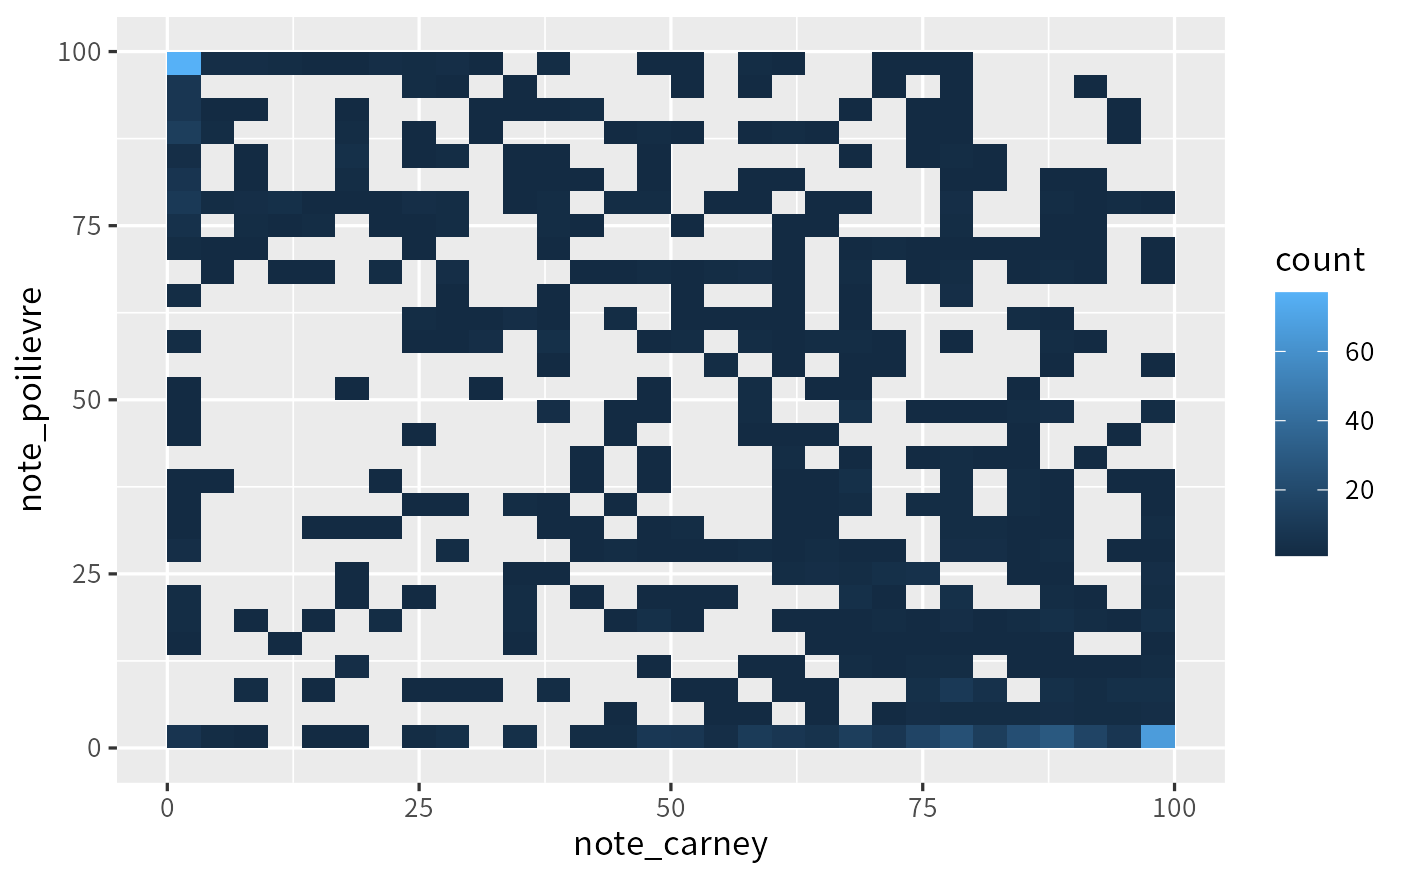
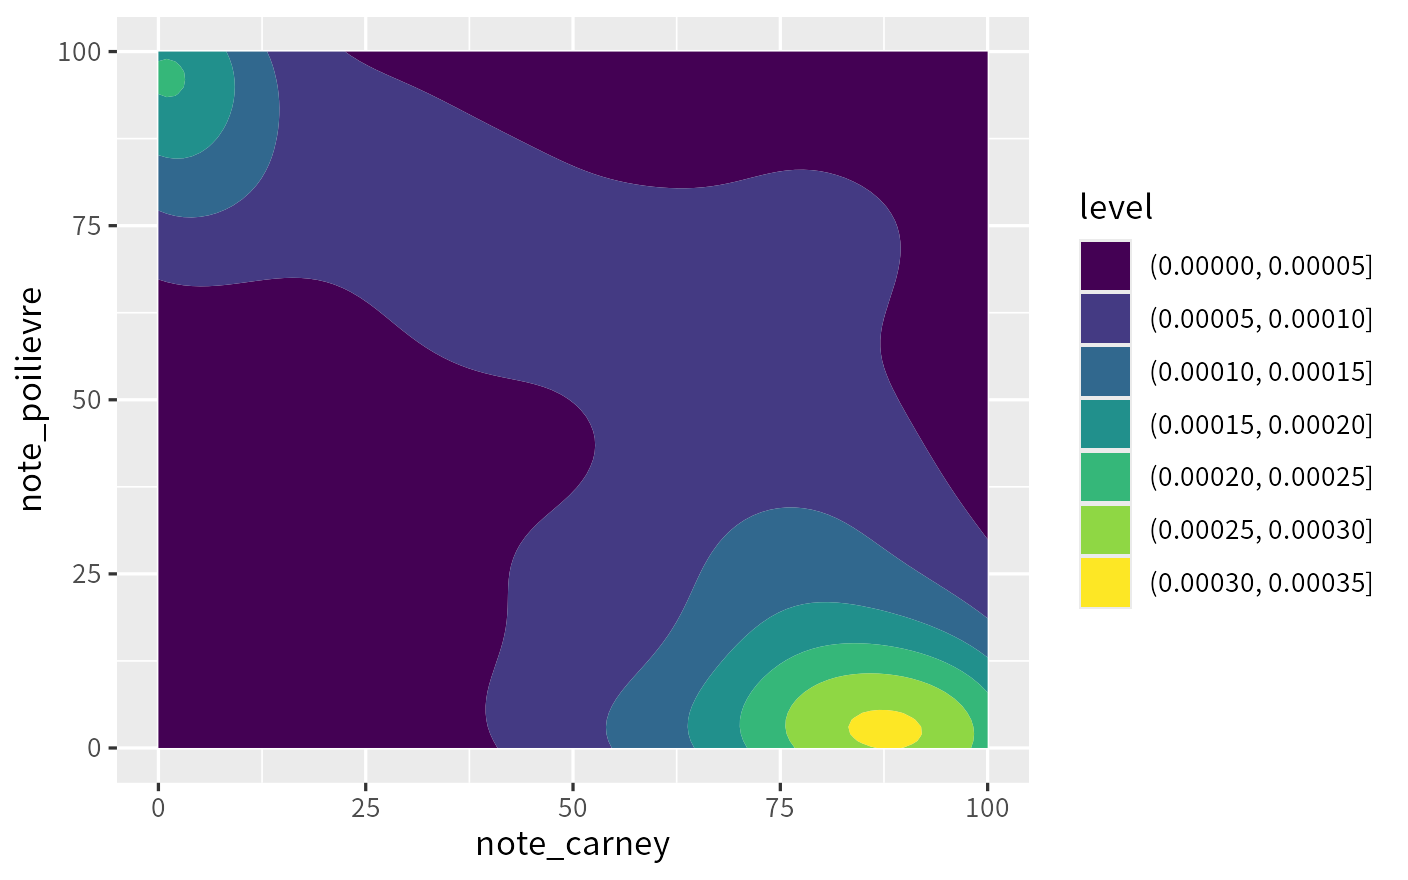
Quel graphique ? Une catégorielle geom_bar()Une numérique geom_histogram()Catégorielle × numérique geom_boxplot()Deux catégorielles table()Deux numériques geom_point()ggplot2 · changer de géométrie POL-2000 · séance 5 · jeu 1er oct
Changer de géométrie ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_point ()ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_count ()ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_bin_2d ()ggplot (ces1000, aes (x = note_carney, y = note_poilievre)) +
geom_density_2d_filled () geom_point() geom_count() geom_bin_2d() geom_density_2d_filled() ggplot2 · changer de géométrie POL-2000 · séance 5 · jeu 1er oct
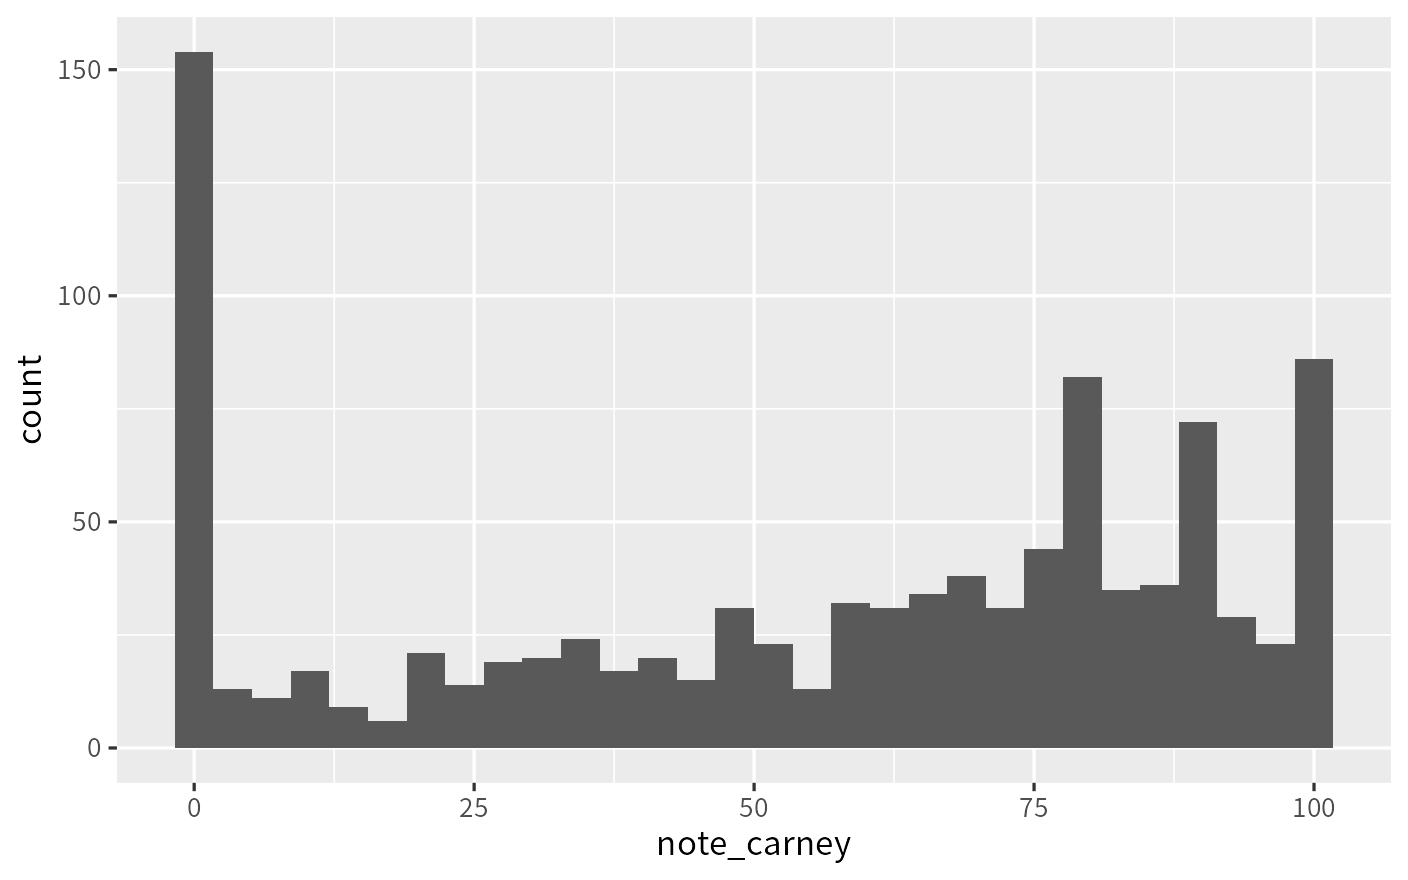
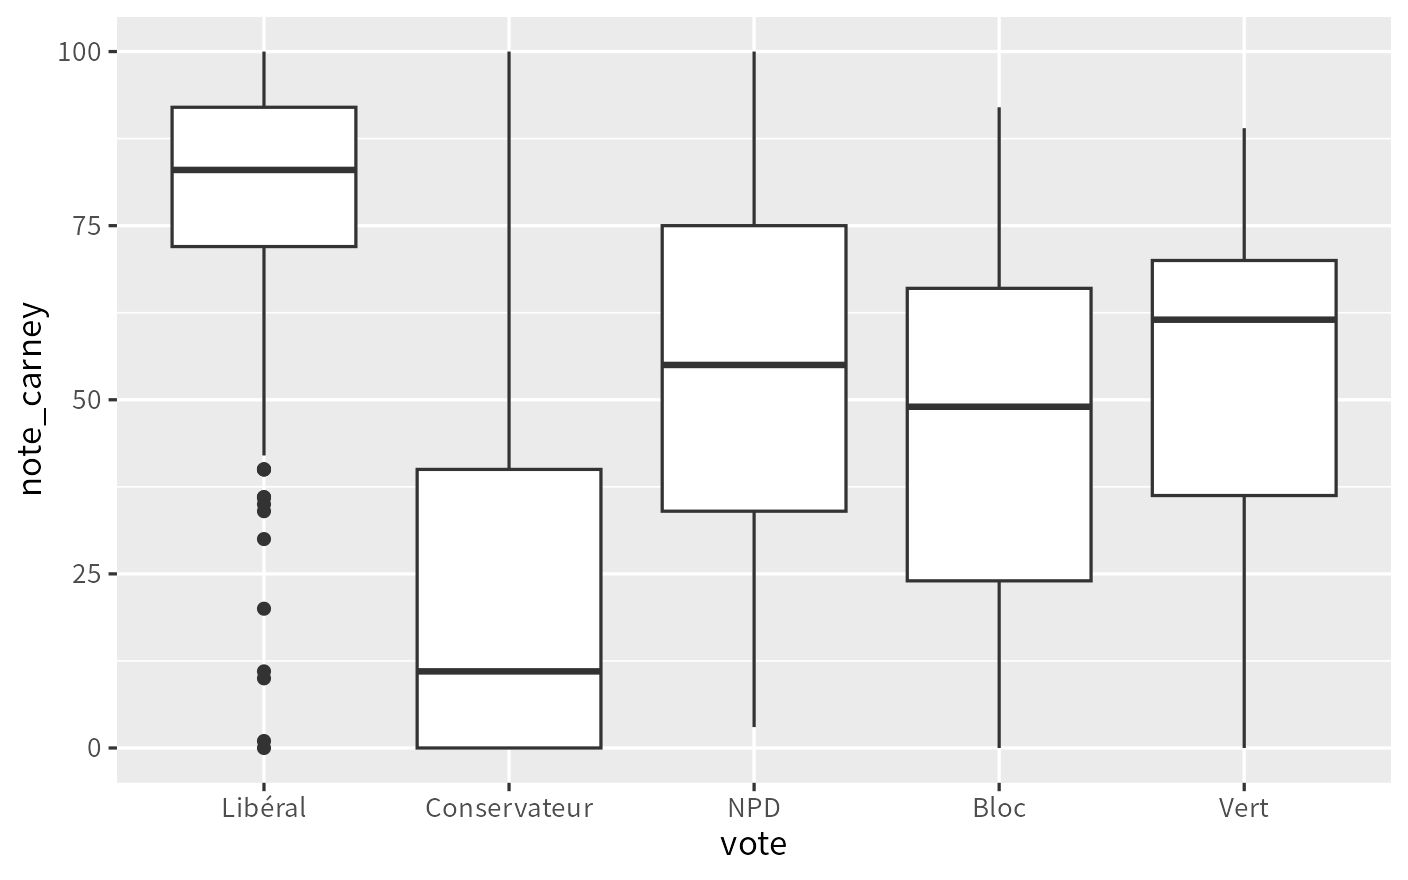
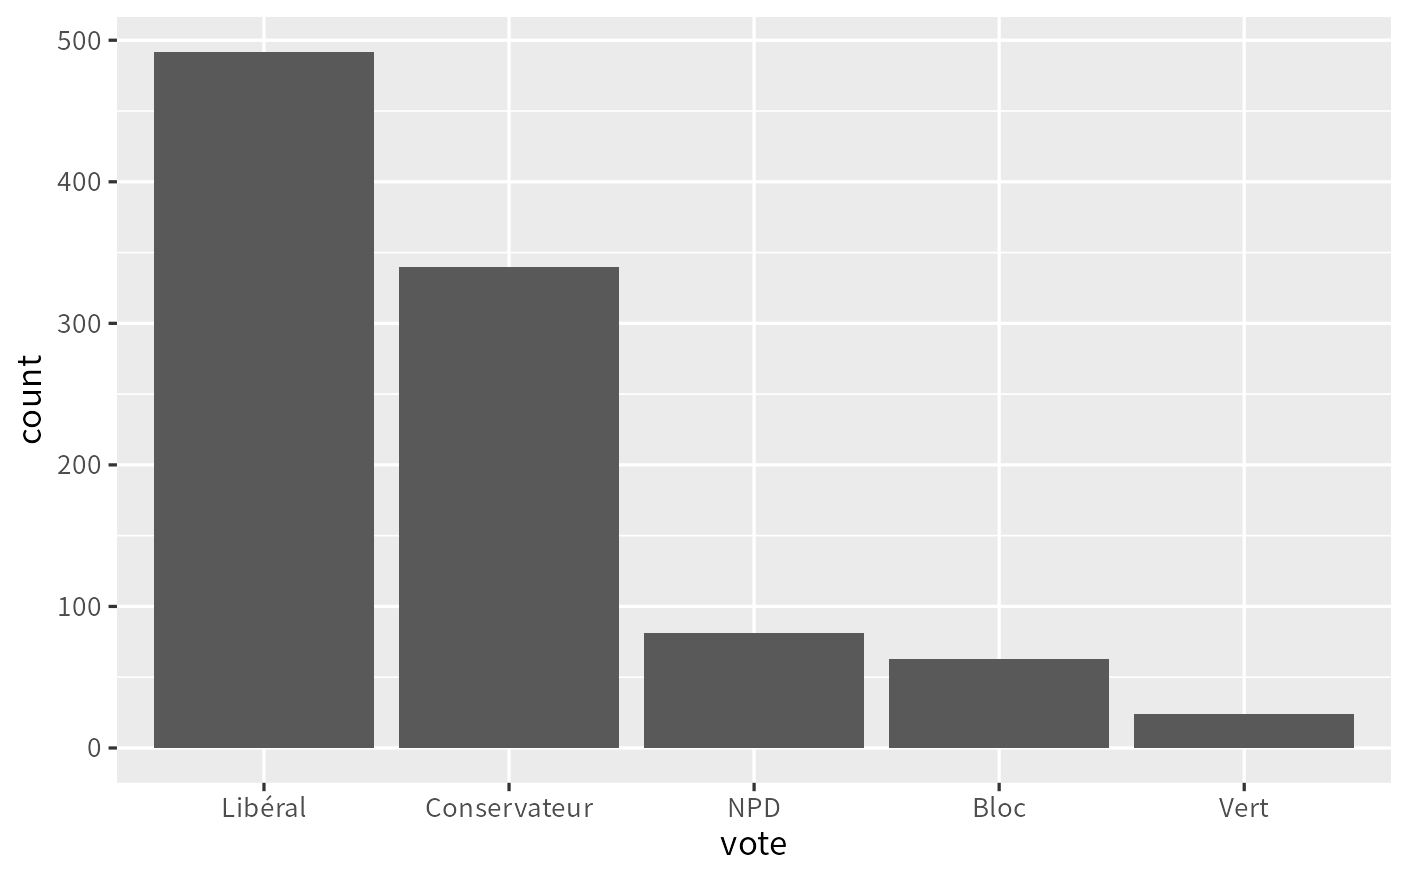
Une autre question, un autre graphique ggplot (ces1000, aes (x = note_carney)+
geom_histogram ()ggplot (ces1000, aes (x = vote, y = note_carney)+
geom_boxplot ()ggplot (ces1000, aes (x = vote)+
geom_bar () geom_histogram() geom_boxplot() geom_bar() Avant le 15 octobre POL-2000 · séance 5 · jeu 1er oct
Avant le 15 octobre POL-2000 · séance 5 · jeu 1er oct
Jeudi 15 octobre La régression linéaire simple.
Laurence-Olivier M. Foisy POL-2000 · séance 5 · jeu 1er oct
Merci. Département de science politique POL-2000 · Automne 2026  Département de science politique
 Datacamp Introduction to the Tidyverse · Data Wrangling · Grouping and Summarizing